

Un token es el trozo mínimo en el que un modelo de inteligencia artificial parte tu texto para poder trabajar con él. A veces es una palabra entera, y muchas otras es media palabra, una sílaba o un signo de puntuación, así que token y palabra no son lo mismo.
En muchas herramientas de IA lo que te agota el plan es cuánto texto mandas y cuánto te devuelve el modelo, no cuántos mensajes escribes. Dos personas con la misma cantidad de mensajes pueden gastar cupos muy distintos.
Sigue leyendo y sabrás por qué tu plan se agota antes de lo que parece, cómo calcular lo que consume cualquier texto en español y qué cuatro cambios lo estiran sin pagar más.
Un modelo de lenguaje trabaja con números, así que antes de responderte convierte tu texto en cifras. Para eso tiene una lista fija de trozos de texto, cada uno con su número, sacada de millones de documentos, y las palabras más habituales entraron en esa lista enteras.
Las menos frecuentes se montan juntando piezas más pequeñas, así que pasa "Necesito una app para gestionar los pedidos de mi tienda online." por el contador de tokens de OpenAI y verás 64 caracteres, 11 palabras y 13 tokens, con "Necesito" partido en "Neces" e "ito".
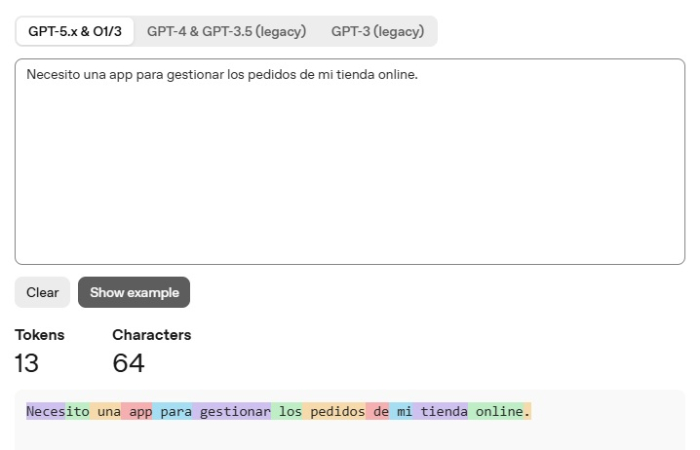
Los espacios y los signos de puntuación suman igual que las letras, y a eso se añaden unas marcas invisibles que el modelo mete para separar cada mensaje. Además, la respuesta se construye igual, token a token, y sale del mismo cupo, así que una contestación larga cuesta tanto como una pregunta larga.
La documentación de OpenAI cifra un token en unos cuatro caracteres, de forma que 100 tokens equivalen a unas 75 palabras. Esa cuenta está medida sobre texto en inglés. La frase del ejemplo anterior, traducida al inglés, tiene 12 palabras y los mismos 13 tokens que sus 11 palabras en español, así que cada palabra española te sale más cara.
En español las palabras se parten más a menudo, y de ahí sale la proporción que te conviene memorizar. Cuenta alrededor de 1,2 tokens por cada palabra, de modo que multiplicas las palabras de tu texto por 1,2 y ya tienes la estimación. Un correo de 300 palabras ronda los 360 tokens.
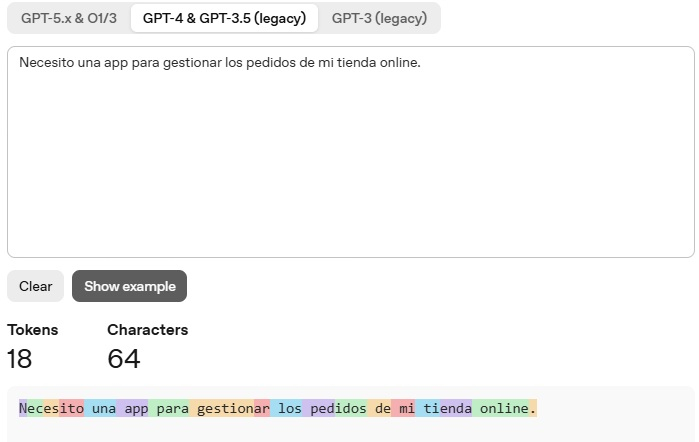
El modelo también cambia la cuenta, así que si en el contador eliges la pestaña de GPT-4 y GPT-3.5, esa misma frase española sube a 18 tokens sin haber cambiado ni una letra. Con Claude o Gemini vuelve a moverse, porque cada empresa entrena su propia lista, así que cada contador sirve solo para los modelos de su casa.
La ventana de contexto es el espacio total de tokens que el modelo tiene delante en una conversación, y ahí dentro caben lo que le envías y lo que te devuelve, los dos del mismo cupo.
En cada mensaje nuevo, la herramienta le reenvía al modelo la conversación entera para que sepa de qué estáis hablando. Tu mensaje número veinte viaja con los diecinueve anteriores encima, así que el gasto se acelera solo aunque tú escribas siempre parecido.
Al llegar al límite, muchas herramientas resumen por su cuenta lo más antiguo para hacer sitio. Ahí es cuando el modelo empieza a perder detalles que le diste al principio y las respuestas se vuelven más genéricas.
Las imágenes, el audio y los ficheros adjuntos también se convierten en tokens, y son los que disparan el gasto sin que se vea. Una captura de pantalla de 1920x1080 son unos 2.700 tokens, lo mismo que dos mil doscientas palabras escritas, así que en una sesión de vibe coding el cupo se va sin que hayas escrito casi nada.
Cada herramienta cobra en su propia unidad, y por eso el mismo trabajo se agota antes en unas que en otras. En la app de Claude hay límites de uso por franjas de tiempo, Bolt descuenta tokens y Lovable descuenta créditos por mensaje.
Para verlo en dinero sirve la tarifa de la API, que es lo que paga quien conecta el modelo a su propio programa en vez de usar la app. En los precios de Claude, Sonnet 5 cuesta 2 dólares por millón de tokens de entrada y 10 dólares por millón de salida, o sea que su respuesta cuesta cinco veces más que tu pregunta.
Cuando agotas el cupo te toca esperar a que se renueve, subir de plan o comprar saldo extra si la herramienta lo vende suelto. Los planes cambian cada pocos meses, así que tenemos el desglose aparte en los precios de Claude Code y en los precios de Cursor.

Los cuatro van de más a menos ahorro, porque los dos primeros recortan lo que entra en cada mensaje, que es por donde se escapa la mayor parte del cupo, y los dos últimos abaratan y acortan lo que sale.
Todo lo hablado antes sigue viajando en cada mensaje aunque ya no tenga nada que ver con lo que preguntas ahora. Un chat limpio pone el contador a cero. El error habitual es mantener una única conversación eterna para todo el proyecto, cuando basta con pegar en el chat nuevo las cuatro decisiones que de verdad necesitas arrastrar.
Casi siempre al modelo le basta con el trozo que falla, así que pega solo el párrafo o las líneas del problema en vez del documento completo. En Bolt se nota el doble, porque cada fichero que sumas al proyecto encarece todos los mensajes que vengan después.
Los modelos más potentes cuestan varias veces más por token que los pequeños de su misma familia, y buena parte del trabajo diario no da para tanto. Resumir un correo largo, corregir el texto de una landing o clasificar cien respuestas de un formulario salen igual de bien con el modelo económico.
Como la salida se paga más cara que la entrada, una instrucción de tres palabras al final de tu mensaje ya cambia la cuenta. Pedir la respuesta en cinco líneas o en forma de lista recorta la explicación que ibas a saltarte, y donde más se agradece es en las preguntas cortas que te devuelven tres párrafos.
Cuando entiendes qué son los tokens en IA ya sabes qué parte de tu plan se está yendo en historiales viejos, en capturas y en respuestas largas. Y con la proporción de 1,2 tokens por palabra calculas lo que va a costarte un texto antes de mandarlo.
Si quieres montar tus propios flujos con IA y no-code sin necesidad de programar, empieza gratis con el curso para automatizar tu negocio y aplica esto desde tu primer proyecto.
Descubre lo que puedes crear en 7 días, sin saber programar
Cada día, un proyecto que podrás construir sin escribir una sola línea de código, directo a tu bandeja de entrada.
Empieza Gratis


Academia de herramientas no-code y low–code


